Разработчики представили Carbon-X — открытую языковую модель с 14,8 миллиарда параметров, обученную на последовательностях ДНК и текстовых данных на естественном языке. Новинка позволяет использовать сырые нуклеотидные последовательности прямо в обычном чате, после чего система отвечает на английском языке, прогнозирует патогенность мутаций, определяет регуляторные участки генов и классифицирует последовательности.
Архитектура модели основана на декодере с 40 слоями, скрытым размером 5120 и гибридным токенизатором. Он объединяет словарь BPE для текста и специальные токены для ДНК, кодируя нуклеотиды непересекающимися 6-мерами. Благодаря этому один токен покрывает 6 пар оснований, а общий контекст достигает 40 960 токенов. Модель требует видеопамять объемом 80 ГБ и запускается на одном GPU с помощью vLLM.
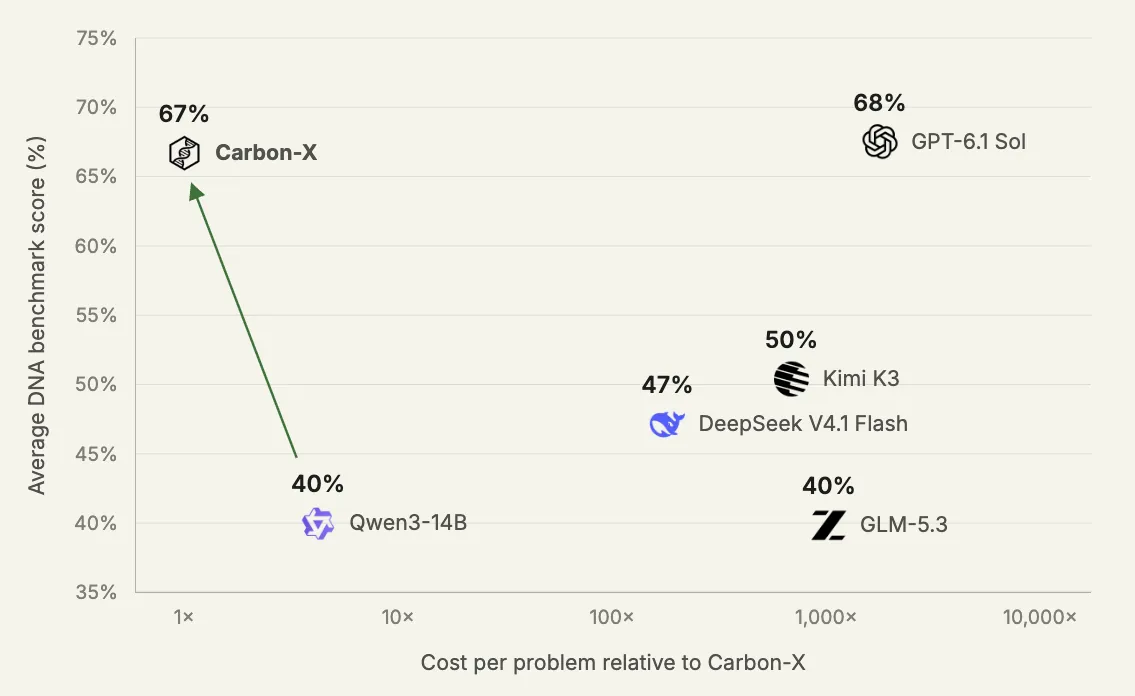
В ходе оценки на пяти профильных бенчмарках Carbon-X продемонстрировала средний результат 66,7% при отключенном режиме рассуждений. Это превышает показатели исходной модели Qwen3-14B и других открытых аналогов, приближая разработку к показателям специализированных систем при значительно меньших затратах на инференс.

Обсуждение в Telegram ↗